
Kỹ thuật & AI
PaddleOCR trích bảng từ PDF scan bằng PP-StructureV3
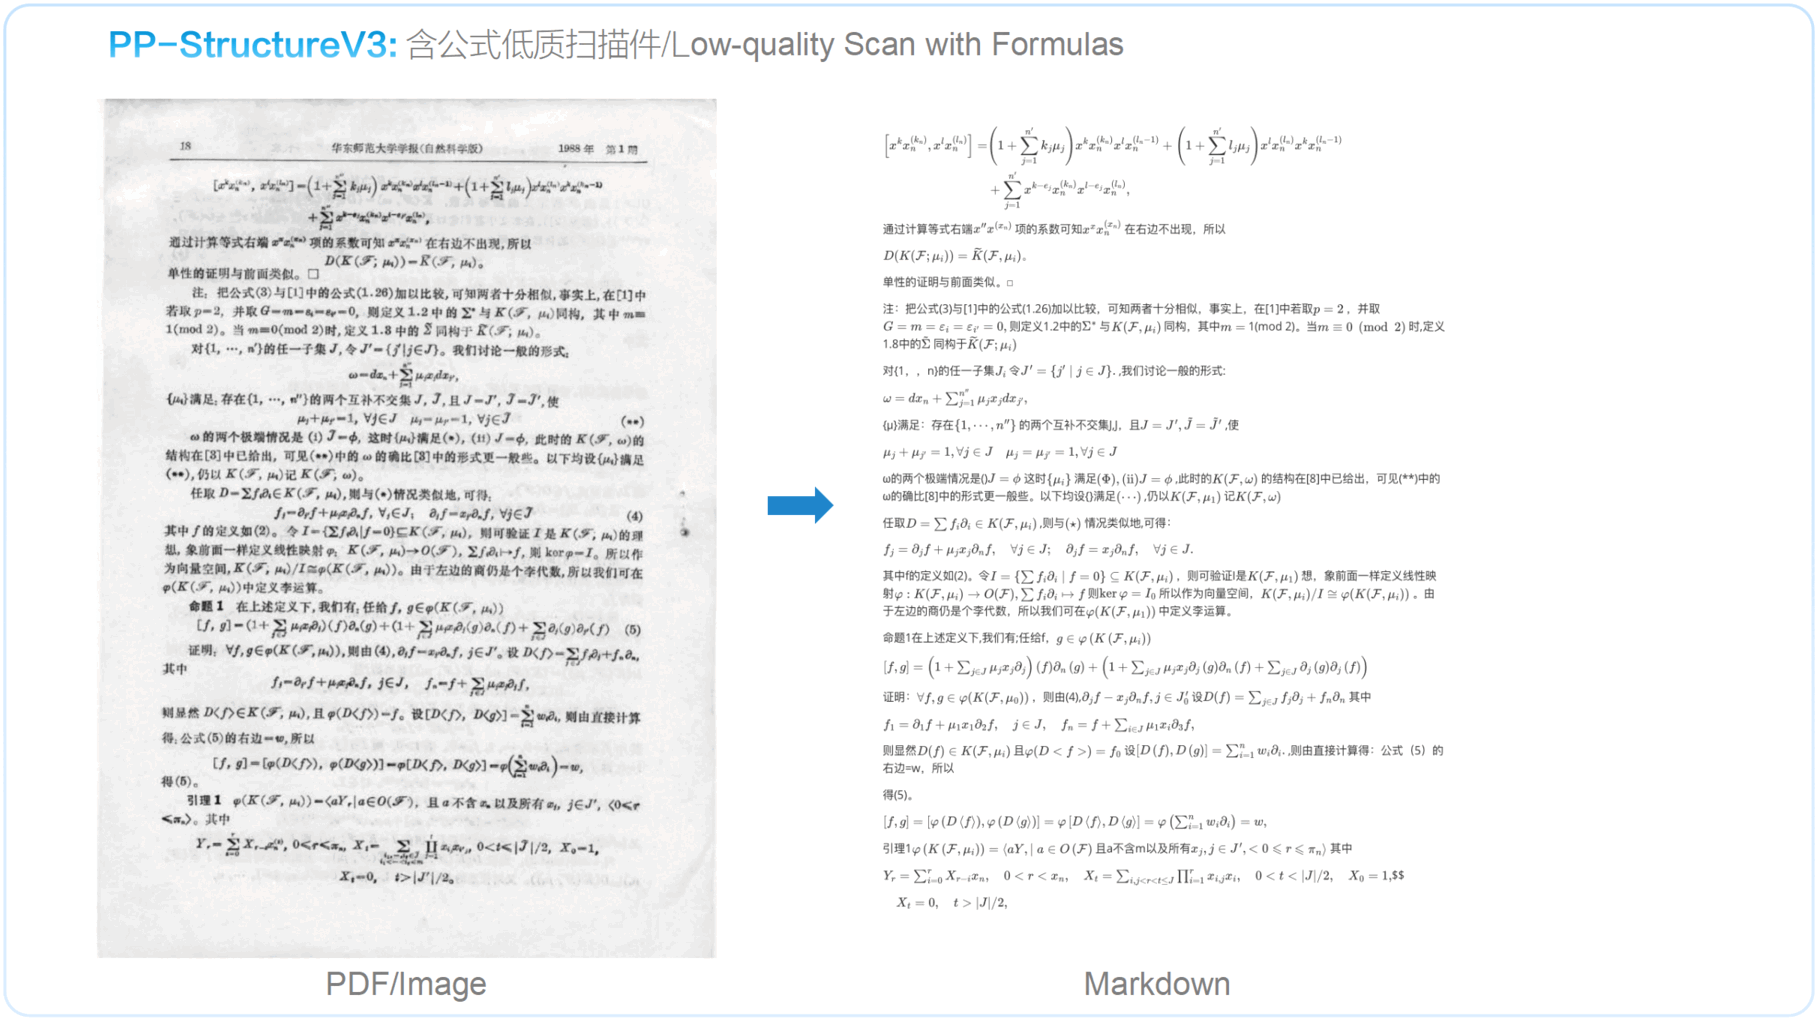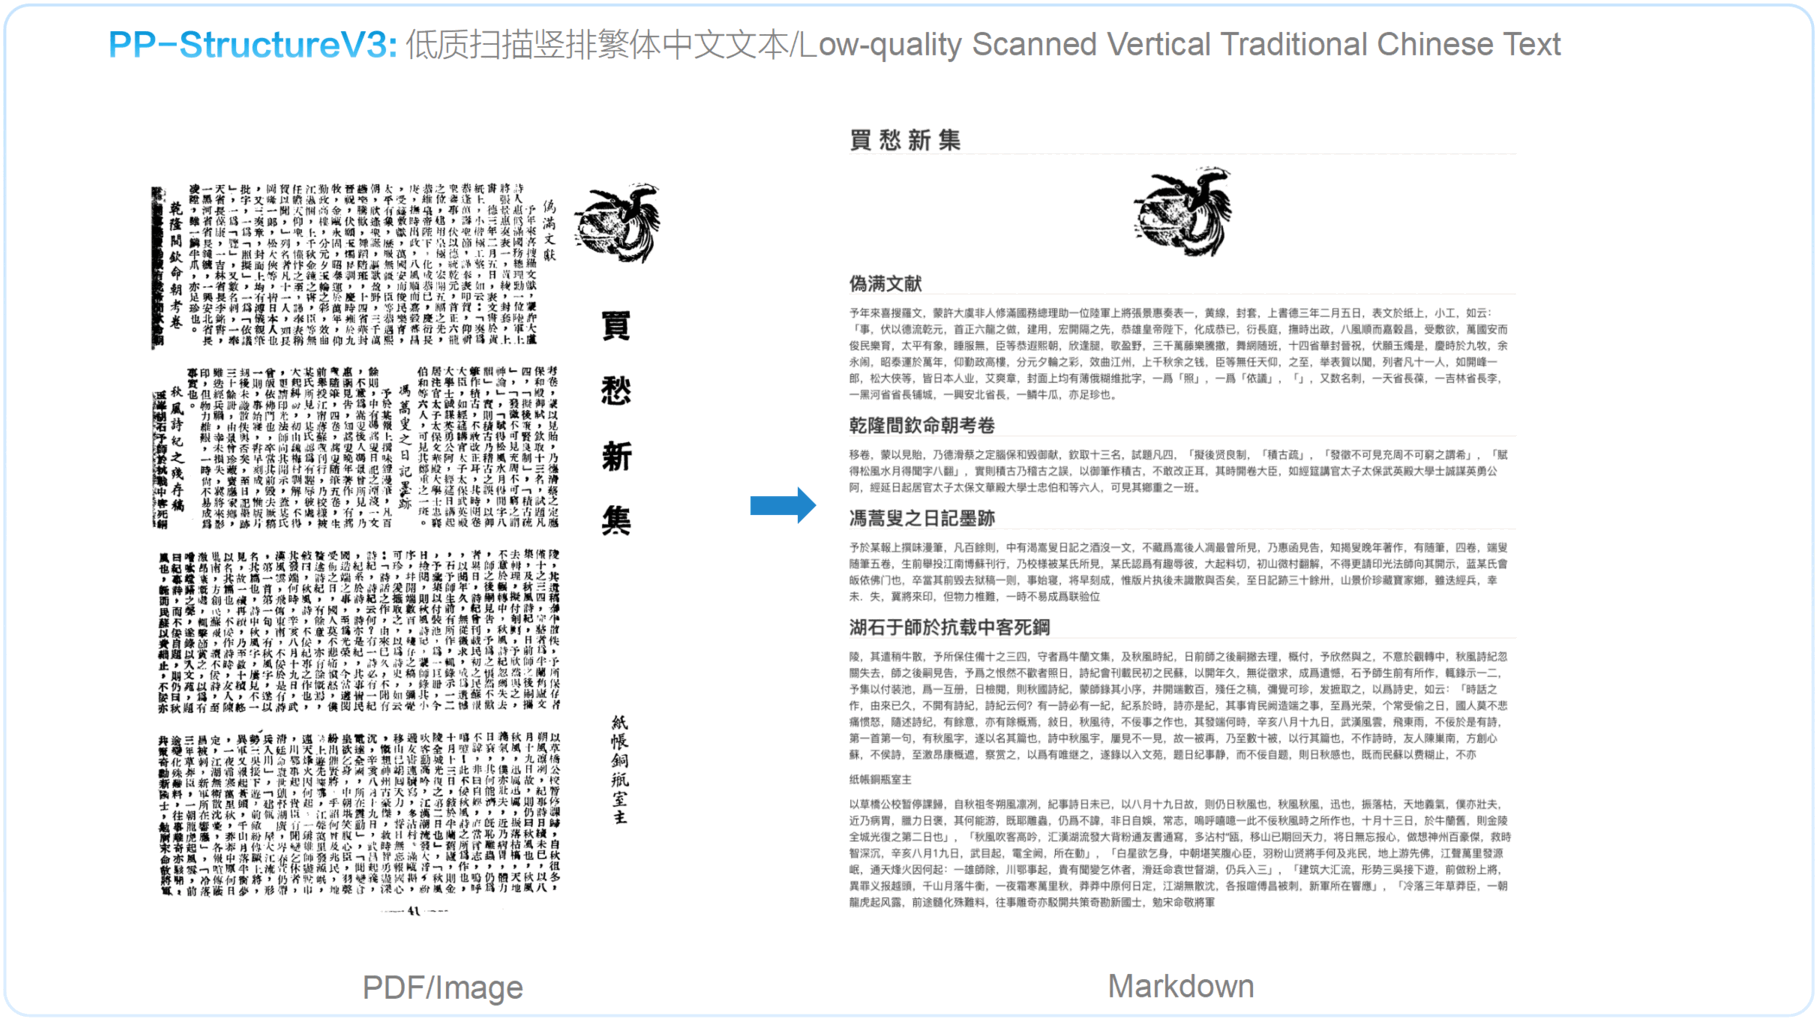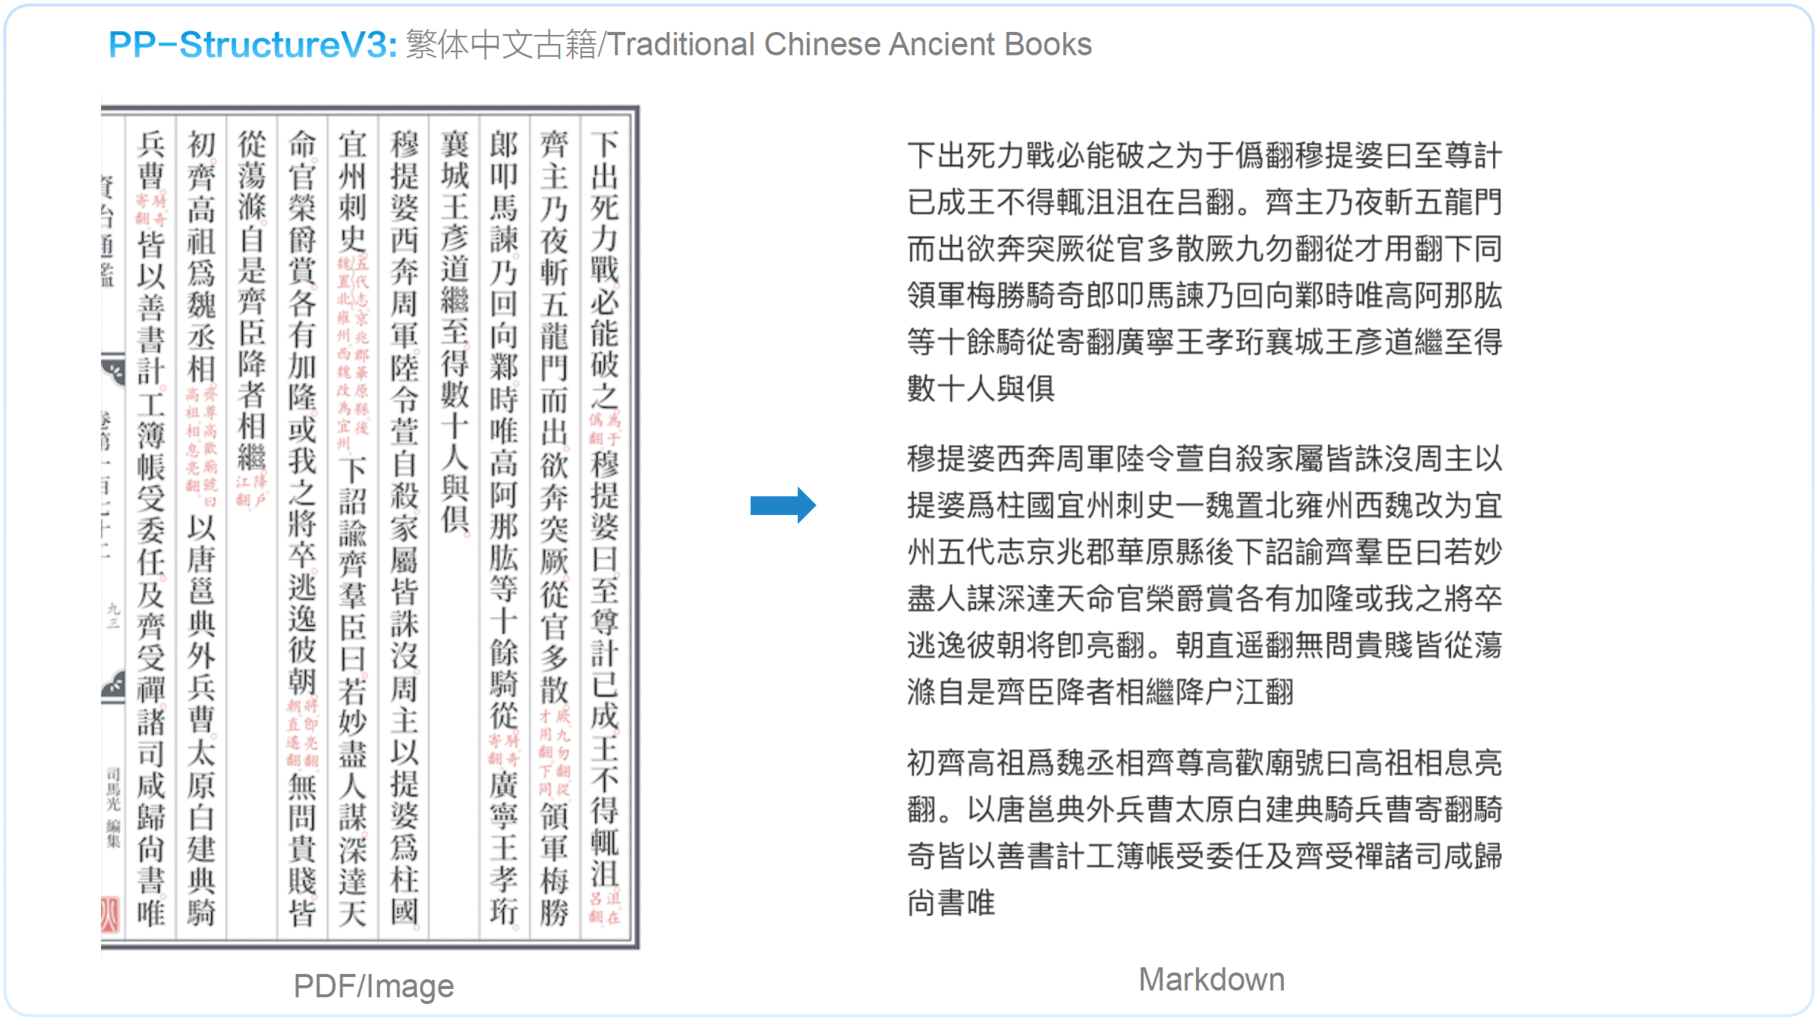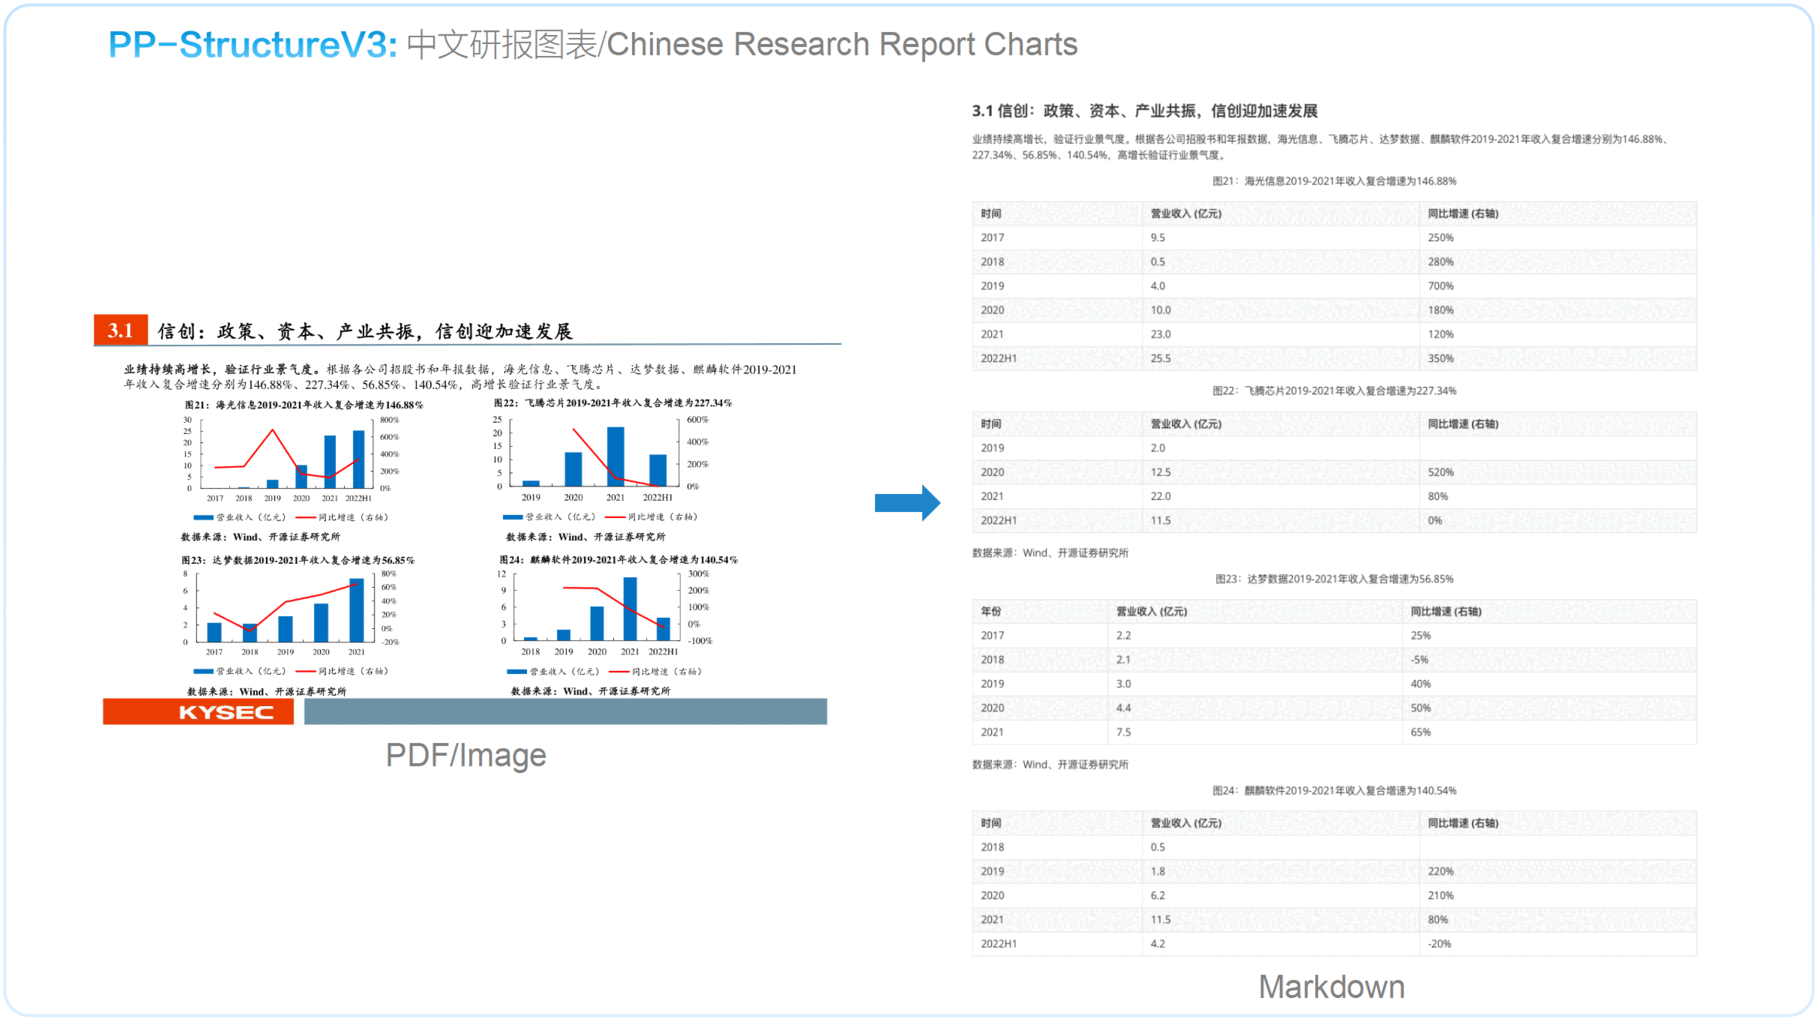
PaddleOCR đọc bảng từ PDF scan và xuất Markdown, JSON để bạn đối chiếu từng hàng, cột và số liệu với bản gốc.
Tóm tắt
- PaddleOCR chuyển bảng trong PDF scan thành dữ liệu có thể đọc và kiểm tra theo từng ô.
- Dùng PP-StructureV3 khi cần nhận diện bố cục và xuất Markdown hoặc JSON.
- Thử trên một trang rồi đối chiếu tiêu đề cột, ô gộp và số tiền với bản scan.
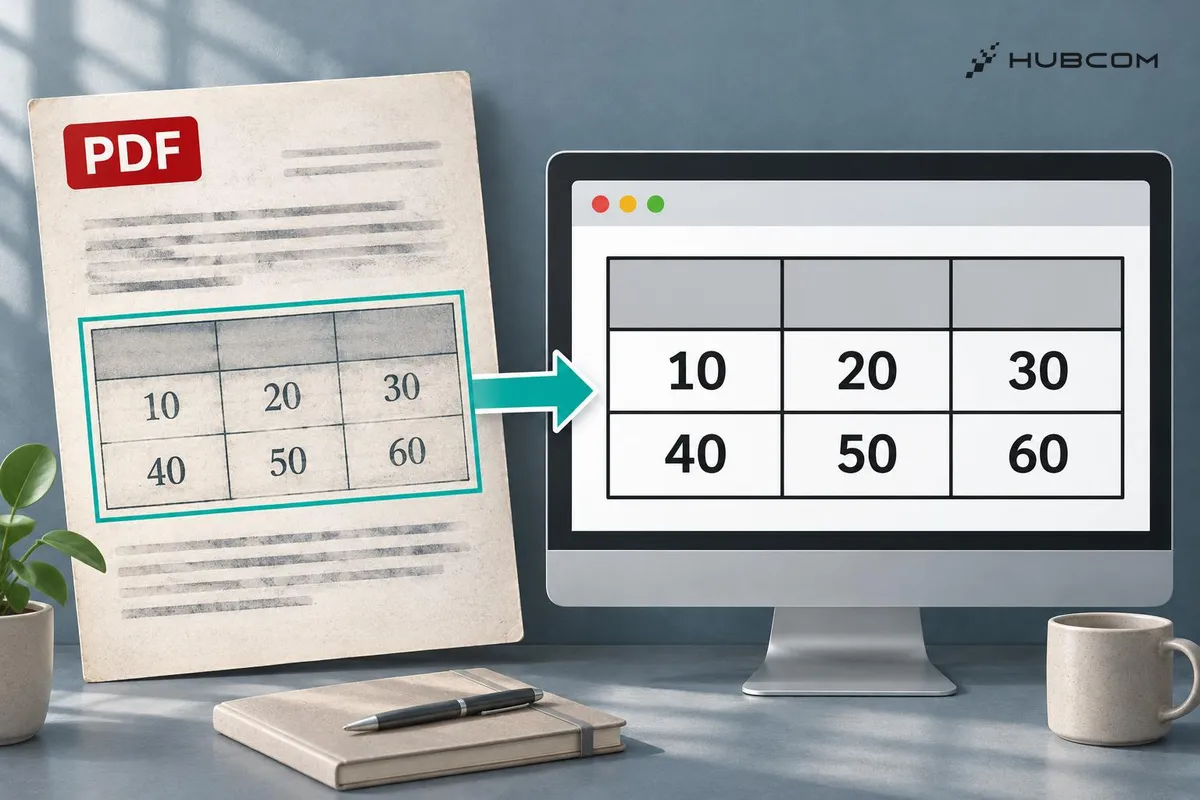
Khi nhận một bảng giá dưới dạng PDF scan, bạn cần lấy đúng cả số tiền lẫn cột chứa số đó. PaddleOCR có pipeline PP-StructureV3 để nhận diện vùng bảng và xuất kết quả cho bạn đối chiếu với trang gốc. Tài liệu PP-StructureV3
Ngày 21/11/2026, HubCom đọc tài liệu và xem mẫu công khai của PaddleOCR v3.7.0. Chúng tôi chưa chạy bài thử bên dưới hay dùng pipeline này trong dự án khách hàng.
Repo giải quyết được gì?
- Lấy dữ liệu từ bản scan. Bạn có thể trích bảng để rà lại từng giá trị, tiêu đề cột và dòng tương ứng.
- Tách bảng khỏi phần chữ xung quanh. Kết quả giữ thông tin theo vùng nội dung để tiện so với trang gốc. Tài liệu PP-StructureV3
Chức năng
- Nhận diện bố cục. Pipeline xác định các vùng như tiêu đề, đoạn chữ, hình và bảng.
- Xuất Markdown và JSON. Mở Markdown để đọc nhanh. Dùng JSON khi cần xử lý kết quả bằng mã. Tài liệu đầu ra
Khi nào nên áp dụng?
Dùng PP-StructureV3 khi trang scan có bảng, nhiều cột hoặc tiêu đề cần giữ đúng thứ tự đọc. Nếu chỉ cần chữ trên một ảnh đơn giản, PaddleOCR cũng có pipeline OCR tổng quát. README
Lưu ý
- Cài đúng nhóm phụ thuộc. Dùng Python 3.9 trở lên cho nhóm
doc-parservà cài PaddlePaddle theo hướng dẫn dành cho hệ điều hành của bạn. Cài PaddleOCR · Cài PaddlePaddle - Chuẩn bị lần tải mô hình đầu tiên. Nếu máy chưa có tệp mô hình, cấu hình mặc định sẽ tải chúng. Tài liệu PP-StructureV3
Thử nghiệm
Chọn một trang bảng giá tiếng Việt có cột mã hàng, số lượng và đơn giá. Dùng bản scan rõ và ghi trước giá trị của một hàng có mã bắt đầu bằng 0. Nếu bảng có ô gộp, ghi lại cột mà tiêu đề đó bao phủ.
Thứ tự triển khai
- Cài gói đã ghim phiên bản. Sau khi chuẩn bị PaddlePaddle, chạy
python -m pip install "paddleocrdoc-parser]==3.7.0". [Hướng dẫn cài - Chạy trên một trang. Lưu bảng giá mẫu thành
sample.pdf, rồi chạy đoạn Python dưới đây để lưu Markdown và JSON. Ví dụ Python - Đối chiếu trước khi xử lý hàng loạt. Mở Markdown và JSON cùng bản scan. Ghi lại ô nhận sai hoặc nằm nhầm cột.
from paddleocr import PPStructureV3

pipeline = PPStructureV3(lang="vi", device="cpu")
for result in pipeline.predict(input="sample.pdf"):
    result.save_to_markdown("ocr-out")
    result.save_to_json("ocr-out")
Bẫy thường gặp
- Số đúng nhưng sai cột. Kiểm tra riêng các dòng gần ô gộp hoặc có chữ xuống hàng.
- Mất số 0 ở đầu mã. Kiểm tra đầu ra gốc và giữ mã dưới dạng chuỗi khi đưa sang hệ thống khác.
Kiểm tra kết quả
- Đếm hàng và cột. So tiêu đề, hàng dữ liệu và ô gộp với bản scan.
- Kiểm tra số và mã. Đối chiếu dấu phân cách, số 0 đầu mã và cột chứa đơn giá.
- Ghi lại ô cần rà tay. Dùng danh sách lỗi để quyết định có thử thêm trang cùng mẫu hay cần cải thiện bản scan.
Không nằm trong bài này
Trích xuất trường hóa đơn theo mẫu cố định, xử lý hàng loạt và huấn luyện mô hình.
Thuật ngữ trong bài (4)
- PaddleOCR
- Bộ công cụ nhận dạng chữ và phân tích tài liệu từ ảnh hoặc PDF.
- PP-StructureV3
- Quy trình nhận diện bố cục và trích các phần tử như bảng, chữ và hình.
- OCR
- Nhận dạng ký tự quang học, tức chuyển chữ trong ảnh thành văn bản máy đọc được.
- Ô gộp
- Ô trong bảng trải qua nhiều hàng hoặc nhiều cột.
Câu hỏi thường gặp
PP-StructureV3 có đọc PDF scan trực tiếp không?
Tài liệu hỗ trợ đường dẫn PDF làm đầu vào. Ví dụ dùng một trang để dễ đối chiếu với kết quả.
Tôi nên mở Markdown hay JSON trước?
Mở Markdown để rà bố cục. Dùng JSON khi chương trình cần đọc các phần tử và thông tin vị trí.
Nguồn tham khảo
- PaddleOCR README, PaddlePaddle
- PaddleOCR v3.7.0, PaddlePaddle
- PP-StructureV3, PaddlePaddle
- PaddleOCR installation, PaddlePaddle
- PaddlePaddle installation, PaddlePaddle